
AI-datastyrning är det ramverk av roller, regler och kontroller som avgör vilka data som får användas i era AI-system, hur de håller rätt kvalitet, vem som bär ansvaret och hur ni kan visa vägen från källa till modell och beslut. I Sverige är det ingen fristående teknikfråga: GDPR, AI-förordningen och era informationssäkerhetskrav gäller samtidigt för samma dataflöden. Den organisation som styr AI-data väl behöver därför juridisk precision och praktiskt genomförande i samma arbete, och det är precis i den skärningen vi på Evertrust arbetar, med rådgivning inom dataskydd, informationssäkerhet och AI-reglering.
Kort sagt
- AI-datastyrning omfattar hela livscykeln: insamling, bearbetning, träning, användning, delning och gallring av data.
- GDPR gäller parallellt med AI-förordningen så snart personuppgifter används, även när en modell tränas eller finjusteras.
- Data lineage, alltså spårbarhet från källa till modell, är både en kvalitetsfråga och ett sätt att visa ansvarsskyldighet mot IMY.
- Rollfördelningen (personuppgiftsansvarig eller biträde) avgörs per behandling och ändras när en leverantör finjusterar modeller.
- Börja med en inventering och en GAP-analys, och bygg sedan kontroller, DPIA:er och dokumentation i ett gemensamt system.
Innehållsförteckning
- Vad AI-datastyrning är, och vad den inte är
- Kraven som styr AI-data i Sverige
- Data lineage: spårbarhet från källa till modell
- Roller och ansvar när modellen finjusteras
- Så inför ni AI-datastyrning i sex steg
- Styr AI-data med Evertrust
- Vår syn på AI-datastyrning
- Vanliga frågor om AI-datastyrning
- Källor
Vad AI-datastyrning är, och vad den inte är
Data governance, eller datastyrning på svenska, beskrivs av Open Data Institute som ett strukturerat ramverk av policyer, processer och standarder för effektiv, etisk och säker hantering av data, uppbyggt kring fem pelare: kvalitet, hantering, säkerhet, åtkomst och etik. Det praktiska arbetet med att samla in, använda och dela data kallas i samma rapport data stewardship. Skillnaden är användbar: styrningen sätter reglerna, förvaltningen följer dem i vardagen.
AI-datastyrning är samma disciplin tillämpad på data som matar AI-system. Det som skiljer den från klassisk datastyrning är tre saker:
- Data får nya användningar. Uppgifter som samlades in för att administrera kundrelationer kan plötsligt bli träningsdata. Det väcker frågan om ändamålsbegränsning enligt GDPR.
- Fel förstärks. En skev datamängd ger inte bara en felaktig rapport, den kan ge en modell som systematiskt behandlar grupper olika.
- Spårbarheten blir svårare. När data har passerat genom förbehandling, inbäddningar och finjustering är det inte längre självklart vilken källa som påverkade vilket utfall.
Det är också därför datastyrning har blivit en förutsättning för AI snarare än ett tillägg. Ekonomistyrningsverket skriver i sitt remissvar på AI-kommissionens färdplan (SOU 2025:12) att tillgång till högkvalitativ, strukturerad och maskinläsbar data är en förutsättning för framgångsrik AI-användning, och tillstyrker ett författningskrav på modern datahantering som främjar datakvalitet, transparens och spårbarhet. Remissvaret gäller myndigheter, men logiken är densamma i ett privat bolag med 500 anställda.
AI-datastyrning är däremot inte detsamma som AI governance i stort. AI governance omfattar även strategi, riskaptit, etik och styrning av själva modellerna. Datastyrningen är det fundament som resten vilar på. Hur ni bygger det övergripande ramverket beskriver vi i guiden om AI governance-ramverk.
Kraven som styr AI-data i Sverige
Det finns ingen enskild lag som heter “AI-datastyrning”. Kraven kommer från flera regelverk som träffar samma data samtidigt.
GDPR gäller från första träningsrundan
Enligt IMY gäller AI-förordningen och GDPR parallellt: GDPR är tillämplig när personuppgifter behandlas vid utveckling eller användning av AI, även vid träning av en modell. AI-förordningen (EU) 2024/1689 bekräftar själv i skäl 10 att den inte påverkar tillämpningen av befintlig unionsrätt om personuppgiftsbehandling, inklusive tillsynsmyndigheternas befogenheter.
För er betyder det att alla klassiska GDPR-frågor ska besvaras för varje AI-tillämpning: rättslig grund, ändamål, information till de registrerade, lagringstid, rättigheter och säkerhet. Om AI-systemet fattar beslut som påverkar enskilda tillkommer reglerna om automatiserat beslutsfattande, som EU-domstolen har preciserat. Vi har sammanfattat domstolens definition av automatiskt beslutsfattande för den som vill gå djupare.
AI-förordningen: datakrav för högrisksystem och AI-kunnighet för alla
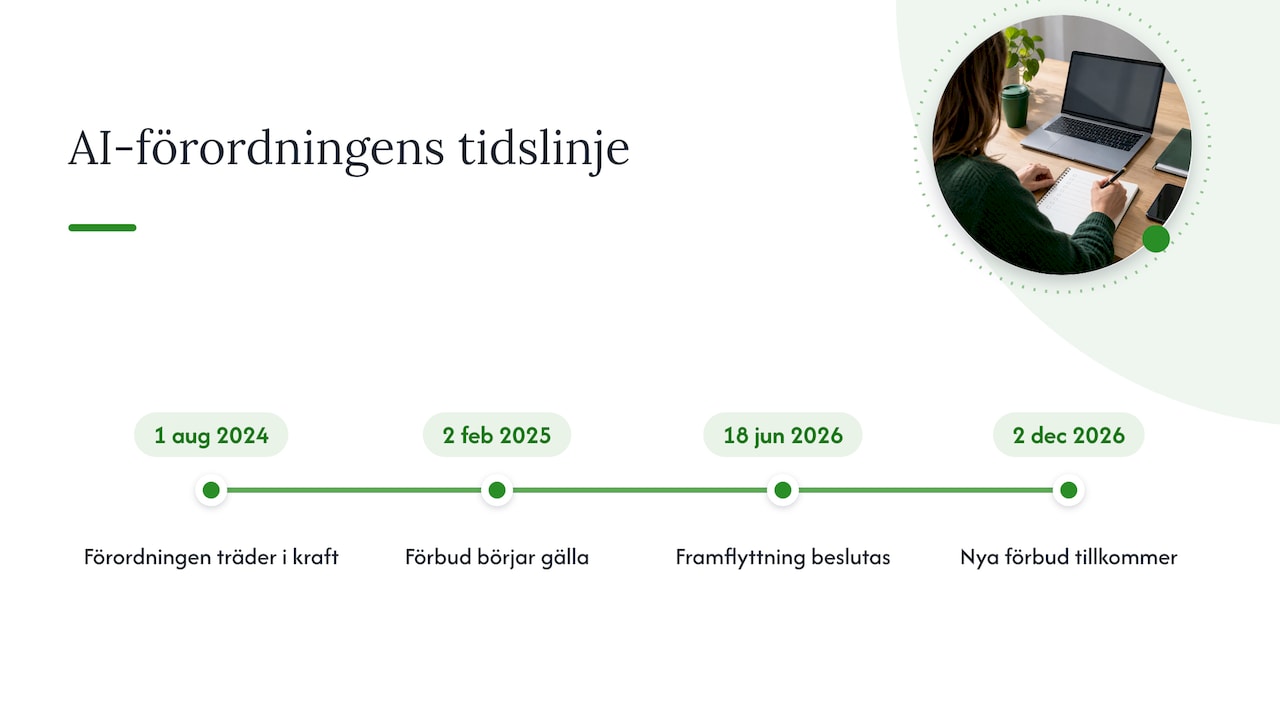
AI-förordningen trädde i kraft den 1 augusti 2024 och tillämpas stegvis. Förbuden mot AI-system med oacceptabel risk gäller sedan den 2 februari 2025. Enligt IMY beslutades den 18 juni 2026, genom ett så kallat digitalt omnibus-förslag, att tillämpningen skjuts fram på flera områden, samtidigt som nya förbjudna tillämpningar läggs till från den 2 december 2026. Tidsplanen har alltså ändrats under resans gång. Utgå från IMY:s frågor och svar för de datum som gäller just när ni planerar, och följ hur svensk lag anpassas till AI-reglerna.
Det mest konkreta datakravet finns i artikel 10, som rubriceras just “Data och dataförvaltning”. Den gäller för högrisk-AI-system och kräver att tränings-, validerings- och testdata omfattas av styrning och förvaltning som är lämplig för systemets avsedda ändamål. Praktikerna ska bland annat omfatta designval, insamlingsprocesser och datans ursprung, för personuppgifter även det ursprungliga ändamålet med insamlingen, förbehandling, undersökning av möjliga snedvridningar samt åtgärder för att upptäcka och minska dem. Datamängderna ska vara relevanta, tillräckligt representativa och så långt möjligt fria från fel och fullständiga, och de ska ta hänsyn till den geografiska och kontextuella miljö där systemet ska användas.
Även om era AI-system inte är högrisk är artikel 10 den bästa checklista som finns för vad god AI-datastyrning innebär. Den som bygger efter den nu slipper göra om arbetet om ett system senare klassas som högrisk.
Ett krav träffar dessutom nästan alla: enligt IMY:s genomgång av artikel 4 måste verksamheter som utvecklar eller använder AI-system vidta åtgärder för att personalen, och andra som arbetar på deras uppdrag, har tillräcklig AI-kunnighet. Kravet gäller alla typer av AI-system, även generativ AI.
Informationssäkerheten bär upp resten
Datastyrning utan informationssäkerhet blir en policy på papper. Åtkomststyrning, loggning, klassning och incidenthantering är de kontroller som gör att reglerna faktiskt följs. Organisationer som redan arbetar efter ISO 27001 och ISO 27002 har här ett försprång, eftersom ledningssystemet går att utvidga till AI-tillgångar. Läs mer om vårt arbete med informationssäkerhet enligt ISO 2700X. För verksamheter som omfattas av NIS2 eller DORA blir AI-systemen och deras dataflöden en del av samma riskhantering.
| Regelverk | Vad det kräver av era AI-data | Gäller vem |
|---|---|---|
| GDPR | Rättslig grund, ändamålsbegränsning, dataminimering, säkerhet, dokumentation och DPIA vid hög risk | Alla som behandlar personuppgifter i AI |
| AI-förordningen, artikel 10 | Styrd datakvalitet, ursprung, representativitet, hantering av snedvridning | Leverantörer av högrisk-AI |
| AI-förordningen, artikel 4 | Åtgärder för personalens AI-kunnighet | Alla som utvecklar eller använder AI-system |
| ISO 27001, NIS2, DORA | Riskbaserad informationssäkerhet, åtkomst, incidenter, leverantörsstyrning | Certifierade eller reglerade verksamheter |
Data lineage: spårbarhet från källa till modell
Data lineage betyder att ni kan visa varifrån en uppgift kommer, vilka steg den har passerat och var den hamnat, i det här fallet i vilken modell, vilken version och vilket beslut. För AI är det skillnaden mellan att kunna förklara ett utfall och att behöva gissa.
IMY skriver i rapporten GDPR vid användning av generativ AI (IMY 2024:9162) att verksamheter som använder generativ AI bör införa mekanismer för spårbarhet vid behandling av personuppgifter, så att det går att verifiera och härleda hur systemet har använts. Dokumentationen av behandlingen beskrivs som en viktig del av ansvarsskyldigheten, och vid hög risk krävs en konsekvensbedömning.
På den tekniska sidan pekar DIGG ut riktningen. I sin rapport om metadata för AI-resurser på Sveriges dataportal föreslår myndigheten en nationell applikationsprofil där standarder som DCAT-AP-SE och MLDCAT-AP kopplar ihop data, modeller och tjänster så att relationerna går att verifiera maskinellt. MLDCAT-AP 3.0.0 innehåller referenser till AI-förordningens krav på teknisk dokumentation, inklusive beskrivning av träningsdata, avsedd användning och riskhantering. DIGG betonar också att ansvaret för en AI-resurs korrekthet och aktualitet ligger kvar hos den organisation som tillhandahåller den.
I praktiken behöver en fungerande lineage-dokumentation svara på fem frågor för varje AI-tillämpning:
- Källa: vilka system och datamängder används, och för vilket ursprungligt ändamål samlades de in?
- Bearbetning: vilken tvätt, anonymisering, pseudonymisering eller berikning har skett?
- Modell: vilken modell och version tränades, finjusterades eller anropades med datan?
- Användning: vilka beslut, processer eller användare tar emot utdata?
- Livslängd: när gallras träningsdata, loggar och promptar, och vad händer med modellen då?
Svaren hör hemma i samma struktur som ert register över behandlingar, inte i ett separat kalkylark som ingen uppdaterar.
Roller och ansvar när modellen finjusteras
Den svåraste frågan i AI-datastyrning är ofta inte teknisk utan juridisk: vem ansvarar? IMY:s rapport om ansvarsroller vid finjustering av AI-applikationer ger ett tydligt svar på principnivå. Först fastställer ni om personuppgifter behandlas och vem som bestämmer ändamålen och de väsentliga medlen. Rollen bedöms sedan separat för varje behandling.
IMY:s exempel är talande. Om en leverantör finjusterar en modell på eget initiativ som en del av sin produktutveckling talar det för att leverantören är personuppgiftsansvarig. Om finjusteringen i stället görs på uppdrag av en kund och enligt kundens instruktioner talar det för att kunden är personuppgiftsansvarig och leverantören personuppgiftsbiträde. Bestämmer ni tillsammans kan det bli fråga om gemensamt personuppgiftsansvar.
Det får direkta följder för era avtal. Ett standardbiträdesavtal räcker sällan när leverantören samtidigt använder er data för att förbättra sin egen modell. Granskningen av AI-leverantörer bör därför följa samma metod som annan leverantörsbedömning enligt GDPR, med särskilda frågor om träning, lagring och återanvändning.
Internt behöver tre roller vara tydliga:
- Dataägare i verksamheten, som beslutar om ändamål och åtkomst.
- Dataskyddsombud, som övervakar efterlevnaden och ger råd om DPIA:er.
- Informationssäkerhetsansvarig, som äger de tekniska kontrollerna.
Så inför ni AI-datastyrning i sex steg
1. Inventera AI-användningen
Kartlägg alla AI-system, även de som köpts in som funktioner i befintliga molntjänster. Det vanliga misstaget är att bara räkna egna utvecklingsprojekt och missa de AI-funktioner som slagits på i CRM, HR-system och kontorsprogram. Vår GDPR-granskning och beredskap och våra GAP-analyser ger en samlad bild av var ni står mot GDPR och AI-förordningen.
2. Klassa risken
Bedöm varje tillämpning både enligt AI-förordningens riskkategorier och enligt GDPR. Här går många fel genom att bara göra den ena bedömningen. Ett system kan vara lågrisk enligt AI-förordningen men ändå kräva DPIA enligt GDPR, till exempel när det behandlar känsliga uppgifter om anställda.
3. Fastställ roller och avtal
Avgör per behandling vem som är personuppgiftsansvarig och biträde, enligt IMY:s resonemang ovan, och uppdatera avtalen. Vi tar rollen som extern dataskyddsombud, privacy counsel eller interim compliance officer när organisationen saknar egen kapacitet för det här arbetet.
4. Säkra datakvalitet och representativitet
SCB beskriver i sin rapport om datadriven utveckling och AI-förmåga hur myndigheten styr data genom hela livscykeln med standarder, metadata och gemensamma tekniska lösningar, och hur den arbetar systematiskt med datakvalitet, representativitet och modellernas påverkan på olika utfall för att undvika diskriminerande resultat. Det är en bra förebild: definiera kvalitetskrav per datamängd, mät dem och dokumentera avvikelser.
5. Gör DPIA och dokumentera spårbarheten
För AI som behandlar personuppgifter i stor skala eller på nya sätt är en konsekvensbedömning ofta obligatorisk. Den vanligaste bristen är en DPIA som beskriver modellen men inte datan. Se vår genomgång av IMY:s tio DPIA-steg. Våra jurister genomför risk- och konsekvensbedömningar (DPIA) och kopplar dem till lineage-dokumentationen.
6. Bygg kompetens och följ upp
Kravet på AI-kunnighet gör utbildning till en efterlevnadsfråga. Därefter krävs regelbunden uppföljning: nya datakällor, nya modellversioner och nya leverantörer ska fångas upp i samma process. Ett GRC-system som tål granskning gör uppföljningen till en rutin i stället för ett projekt.
Styr AI-data med Evertrust
Evertrust arbetar med GDPR, dataskydd, informationssäkerhet, IT-juridik och AI-reglering, och vi stöttar organisationer med bedömningar, compliance-program, avtal, DPIA:er och praktiskt genomförande. Ni kan anlita oss för ett avgränsat uppdrag, ett rådgivningspaket på 100 timmar eller en löpande roll som externt dataskyddsombud. Läs mer om vår rådgivning och våra konsulttjänster.

För den löpande styrningen har vi utvecklat GRC-plattformen Trustview, skapad av jurister och experter för att automatisera och förenkla efterlevnaden enligt GDPR, ISO 27000, DORA, NIS2 och E-privacy. Vill ni först bygga kunskap i organisationen finns vårt webbinarium om AI och personuppgiftshantering och våra utbildningar i GDPR.
Vår syn på AI-datastyrning
Vi ser AI-datastyrning som en efterlevnadsfråga som råkar handla om teknik, inte tvärtom. De organisationer som lyckas behandlar inte AI som ett separat spår med egna policyer, utan låter samma register, samma riskbedömningar och samma kontroller omfatta både klassiska system och AI.
Därför bygger vi arbetet på juridisk grund. Rollfördelningen vid finjustering, ändamålsprövningen när gammal data blir träningsdata och kopplingen mellan DPIA och AI-förordningens datakrav är bedömningar som kräver specialister inom dataskydd och IT-juridik. Samtidigt måste resultatet gå att använda: en ansvarsfördelning som teamet förstår, kontroller som går att följa och dokumentation som håller när IMY ställer frågor.
Det är skälet till att vi kombinerar konsulttjänster med Trustview. Rådgivningen ger rätt bedömning, och plattformen, skapad av jurister och experter, är byggd för att automatisera och förenkla det löpande compliance-arbetet så att styrningen blir en del av vardagen och inte ett dokument i en mapp.
Jesper
Vanliga frågor om AI-datastyrning
Vad är skillnaden mellan AI governance och AI-datastyrning?
AI governance är den övergripande styrningen av AI i organisationen: strategi, riskaptit, etik, ansvar och kontroll av modeller. AI-datastyrning är den del som rör datan som går in i och ut ur systemen. Utan styrd data går det inte att visa att modellerna är rättvisa, säkra eller lagliga.
Gäller kraven oss om vi bara använder färdiga AI-tjänster?
Ja. GDPR gäller så snart personuppgifter behandlas, oavsett om ni utvecklar modellen själva eller använder en molntjänst. Kravet på AI-kunnighet i artikel 4 gäller också den som använder AI-system. Ni behöver dessutom reda ut rollerna med leverantören och säkerställa att avtalen reglerar om er data används för träning.
Behöver vi göra en DPIA för våra AI-system?
En konsekvensbedömning krävs när behandlingen sannolikt leder till hög risk för de registrerade, vilket ofta är fallet med ny teknik, stora datamängder, profilering eller känsliga uppgifter. IMY lyfter konsekvensbedömning som en del av ansvarsskyldigheten vid generativ AI. Vi hjälper gärna till att bedöma om en DPIA krävs och att genomföra den.
Vad betyder data lineage i AI-sammanhang?
Data lineage är spårbarheten för data från källsystem, via bearbetning och träning, till modell och användning. Den gör det möjligt att förklara ett utfall, rätta fel, besvara en registrerads begäran och visa efterlevnad mot tillsynsmyndigheten.
Källor
- Open Data Institute: Data governance in AI, a lifecycle perspective
- Ekonomistyrningsverket: remissvar på AI-kommissionens färdplan (SOU 2025:12)
- IMY: Frågor och svar om AI-förordningen
- Europeiska kommissionen, AI Act Service Desk: artikel 10
- IMY: GDPR vid användning av generativ AI (IMY 2024:9162)
- DIGG: Metadata för AI-resurser på Sveriges dataportal
- IMY: Ansvarsroller enligt GDPR vid finjustering av AI-applikationer
- SCB: SCB:s datadrivna utveckling och AI-förmåga

